In diesem Artikel
- Was IBM 2026 tatsächlich angekündigt hat
- Eine ISA ist ein Vertrag mit der Software
- Warum IBM-Z-Software eine eigene Welt bildet
- Was AArch64 in dieses Bild einbringt
- Ein Kerndesign mit zwei nativen Befehlssätzen
- Zwei Programme, Befehl für Befehl nachvollziehbar
- Eine Transaktion spricht mit einem getrennten Arm-Service
- Transaktionsnahe KI: Motivation und technische Grenzen
- Telum II, Spyre und die Frage nach der Verfügbarkeit
- Welche Fragen noch offenbleiben
- Das Konzept selbst ausprobieren
- Quellen und technische Referenzen
Ein Prozessorkern wird gewöhnlich über eine Architektur vorgestellt: Dieser führt x86-64 aus, jener AArch64, ein anderer IBM Z. Verschiedene Generationen können denselben Befehlssatz sehr unterschiedlich umsetzen. Für die Software bleibt jedoch ein erkennbarer Vertrag bestehen. Genau deshalb ist IBMs Ankündigung vom August 2026 interessant: Ein zukünftiges Kerndesign soll sowohl IBM-Z- als auch Arm-Befehle nativ unterstützen.
Um diese Idee dreht sich mein neues Dual-ISA-Prozessorlabor. Du wählst einen Kern, führst zwei kleine Programme schrittweise aus, untersuchst Register und verfolgst eine fiktive Service-Anfrage. Dabei bleiben veröffentlichte Architekturangaben und die selbst entwickelte Lernumgebung erkennbar getrennt. Diese Trennung gehört zum technischen Verständnis dazu.
Was IBM 2026 tatsächlich angekündigt hat
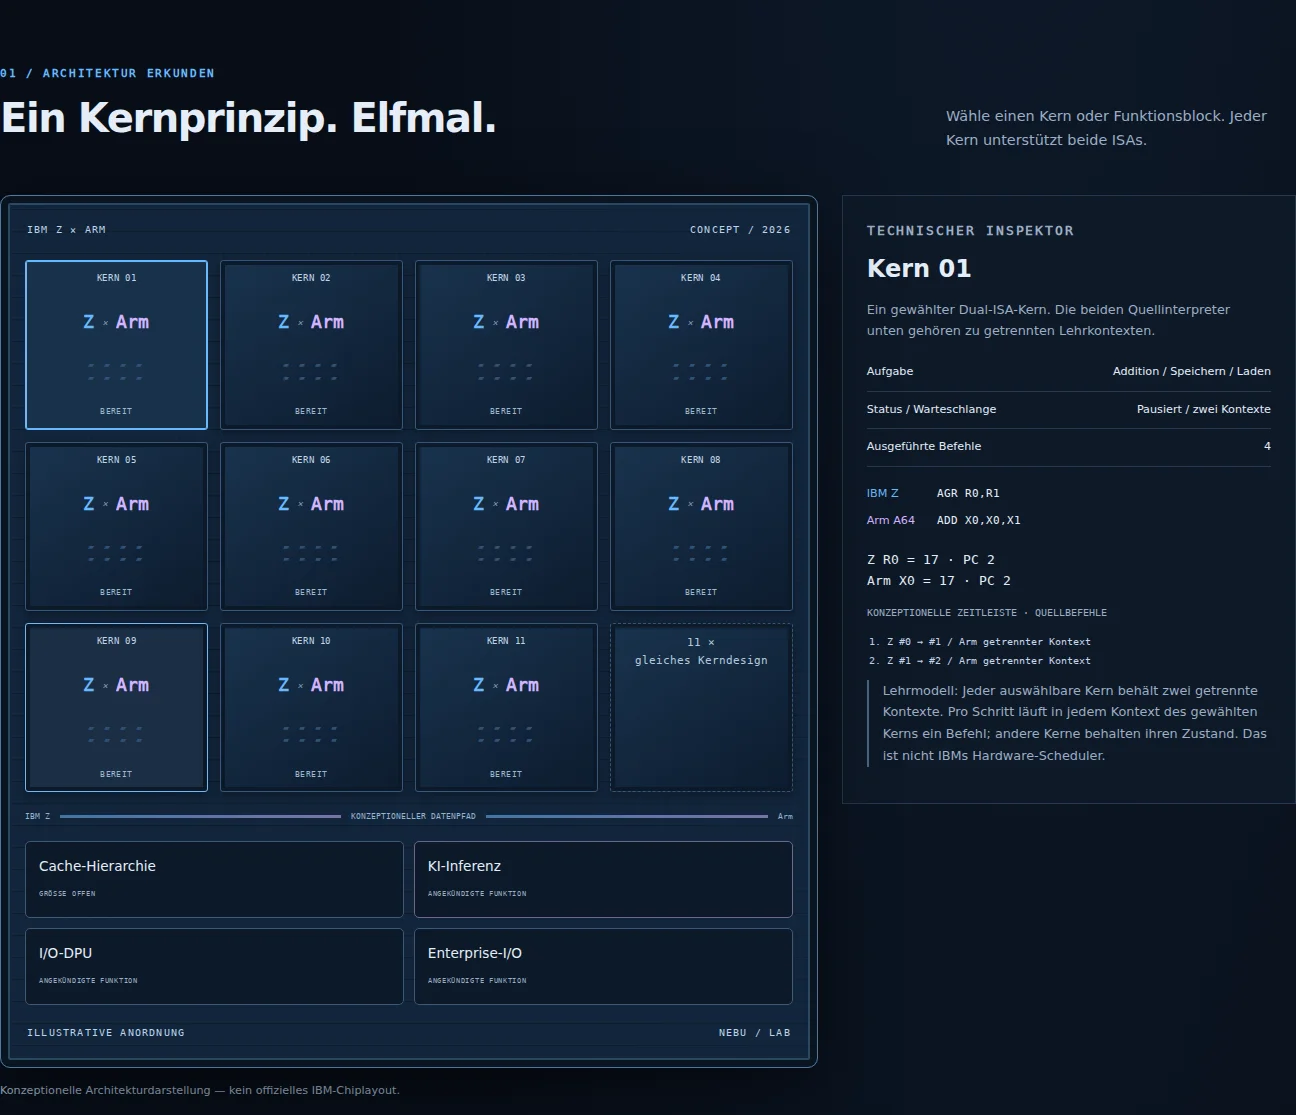
Am 2. April 2026 kündigten IBM und Arm ihre Zusammenarbeit an. Als Arbeitsfelder nannten sie unter anderem Virtualisierung, Unternehmensanforderungen und die Erweiterung des Softwareangebots. Am 24. August stellte IBM auf der Hot Chips dann ein zukünftiges Prozessordesign mit nativer Unterstützung beider Architekturen in jedem Kern vor. Auch Arms begleitender Beitrag bestätigt diesen Ansatz pro Kern. Das unterscheidet sich wesentlich von dedizierten Arm-Kernen neben dedizierten Z-Kernen. [1] [2] [3]
Zu den veröffentlichten Designzielen gehören elf Hochleistungskerne, ein 2-nm-Technologieknoten und mehr als 5,7 GHz sowie integrierte Inferenzbeschleunigung, eine On-Chip-DPU für I/O und eine große Cache-Architektur. Es handelt sich um angekündigte Auslegungsdaten. Unsere Ausstellung misst diese Werte nicht nach. Einen kommerziellen Veröffentlichungstermin belegen die genannten Quellen ebenfalls nicht. [2]
Auf dieser überschaubaren Faktengrundlage erklärt der Artikel allgemeine Architekturprinzipien und die Umsetzung meines eigenen Labors. Aus einem Werbediagramm lässt sich keine vollständige interne Pipeline ableiten. Eine gute Lernumgebung macht deshalb ihre Annahmen genauso sichtbar wie ihre Register.
Eine ISA ist ein Vertrag mit der Software
Die Instruction Set Architecture, kurz ISA, beschreibt die maschinennahe Schnittstelle eines Prozessors. Rechenbefehle sind ihr auffälligster Bestandteil. Dazu gehören aber auch Register, Adressierung, Bedingungsinformationen und Regeln für Speicherzugriffe. Die privilegierte Architektur ergänzt Mechanismen für Betriebssysteme. Ein Befehlssatz ist damit deutlich mehr als ein Wörterbuch mit Verben wie ADD oder LOAD.
Nehmen wir eine Addition zweier 64-Bit-Werte. Software muss wissen, woher die Operanden kommen, wohin das Ergebnis geschrieben wird und was bei einem mathematisch zu großen Ergebnis geschieht. Verändert der Befehl Bedingungsinformationen? Darf ein Operand direkt aus dem Speicher stammen? Welche Ausnahmen können auftreten? Solche Details bestimmen, ob ein Compiler korrekten Code erzeugt.
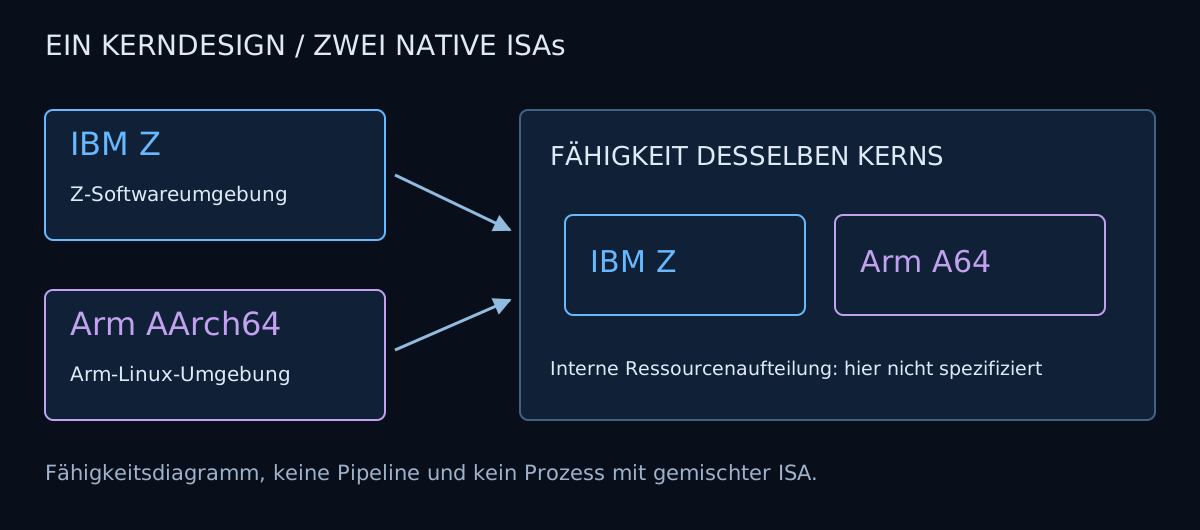
Die physische Umsetzung erfüllt diesen Vertrag mit Decodierung, Pipelines, Caches und Ausführungseinheiten. Mehrere Prozessoren können dieselbe ISA unterstützen und trotzdem unterschiedliche Laufzeiten, Leistungsaufnahmen und interne Strukturen haben. Umgekehrt verrät die native Unterstützung zweier ISAs noch nicht, welche Ressourcen sie intern gemeinsam nutzen. Die Zusage einer Fähigkeit ist keine vollständige Bauanleitung.
Kompatibilität besteht außerdem aus mehreren Schichten. Ein Prozessor muss die Befehlsbytes verstehen. Zusätzlich benötigt das Programm passende Betriebssystemdienste, Bibliotheken und eine kompatible Application Binary Interface, kurz ABI. Ein AArch64-Programm wird nicht dadurch zu einer z/OS-Anwendung, dass beide Befehlssätze vom zugrunde liegenden Kern unterstützt werden.
Warum IBM-Z-Software eine eigene Welt bildet
IBM Z ist eng mit langlebigen Unternehmensanwendungen und Transaktionsverarbeitung verbunden. Eine Transaktion ist mehr als eine schnelle Rechnung. Sie beschreibt eine zusammengehörige Änderung des Geschäftszustands: Kontobewegungen, Warenbestände oder Reservierungen müssen trotz Fehlern und paralleler Anfragen sinnvoll bleiben. Der Prozessor ist dabei Teil eines Systems aus Speicher, Datenbanken, Betriebssystem und Betriebsabläufen.
z/OS und Linux auf IBM Z sind verschiedene Softwareumgebungen. Dass sie die IBM-Z-Befehlsarchitektur nutzen, macht ihre Programmschnittstellen nicht austauschbar. Für Desktop-Linux-Nutzer ist das ein hilfreicher Vergleich: „Läuft auf dieser CPU“ und „läuft unter diesem Betriebssystem“ sind unterschiedliche Anforderungen. Die Architekturdokumentation beschreibt die Maschinenebene, die jeweilige Umgebung ergänzt den Rest. [4]
Im Exponat steht eine gekennzeichnete Z-Anwendung stellvertretend für die Transaktionsseite. Dahinter läuft keine z/OS-Instanz. Auch Channels, Datenbankprotokolle und Wiederherstellungsgarantien werden nicht simuliert. Der Fokus liegt auf der Stelle, an der eine Anwendung ein Ergebnis aus einer anderen Umgebung anfordert und dafür eine definierte Schnittstelle braucht.
Was AArch64 in dieses Bild einbringt
AArch64 bezeichnet Arms 64-Bit-Ausführungszustand; A64 ist der zugehörige Befehlssatz. Das Arm-Listing im Labor arbeitet mit 64-Bit-X-Registern und einer bewusst kleinen Befehlsauswahl. Es deckt weder sämtliche optionalen Architekturmerkmale noch Vektorerweiterungen, Privilegstufen oder Betriebssystemkonventionen ab. Für reale Binärprogramme sind diese Unterschiede und ihre Abhängigkeiten durchaus entscheidend. [5]
Für Unternehmen kann vorhandene Software genauso wichtig sein wie reine Rechenleistung. Eine unterstützende Anwendung ist vielleicht bereits für Arm Linux entwickelt, paketiert und getestet. Eine solche Umgebung näher an ein Transaktionssystem zu bringen, eröffnet andere Bereitstellungsmöglichkeiten. Passende Bibliotheken, Betrieb und ein unterstütztes Betriebssystem werden dadurch aber nicht überflüssig.
Container zeigen diese Grenze besonders anschaulich. Sie bündeln eine Anwendung und ihre Userspace-Abhängigkeiten, entfernen jedoch nicht deren Maschinenarchitektur. Ein Image mit AArch64-Binärdateien braucht weiterhin eine geeignete Ausführungsumgebung. Ein Index mit mehreren Architekturvarianten kann das passende Image auswählen. Er ist selbst kein Befehlsübersetzer.
Ein Kerndesign mit zwei nativen Befehlssätzen
Die zentrale veröffentlichte Aussage lautet: Jeder Kern soll beide Architekturen nativ unterstützen. Arm beschreibt ebenfalls das Nebeneinander der Softwareumgebungen und grenzt den Ansatz von einem separaten Arm-Subsystem ab. Damit ist die Architekturabsicht benannt. Die genaue Ressourcenvergabe, Befehlsdecodierung und Betriebssystemintegration sind daraus noch nicht vollständig ableitbar. [3]
Meine Visualisierung wiederholt deshalb elfmal dieselbe Kennzeichnung Z × Arm. Die Auswahl eines Kernfelds bestimmt, welches Paar von Lehrkontexten du untersuchst. Du kannst ein Paar ausführen, einen anderen Kern auswählen und dort neue Register vorfinden. Beim Zurückkehren ist der vorherige Zustand noch da. So werden Fähigkeiten und Kontexte greifbar, ohne IBMs Dispatch-Verfahren zu erfinden.
Ein sichtbarer Laborschritt führt jeweils einen Befehl in zwei unabhängigen JavaScript-Interpretern aus. Diese Kopplung dient dem Vergleich. Sie behauptet weder gleichzeitige Hardwareausgabe noch gemeinsam genutzte Register oder einen Prozess, der einfach in eine Binärdatei der anderen ISA springt. Die reale Umsetzung muss den von jeder Softwareumgebung erwarteten Architekturzustand erhalten.
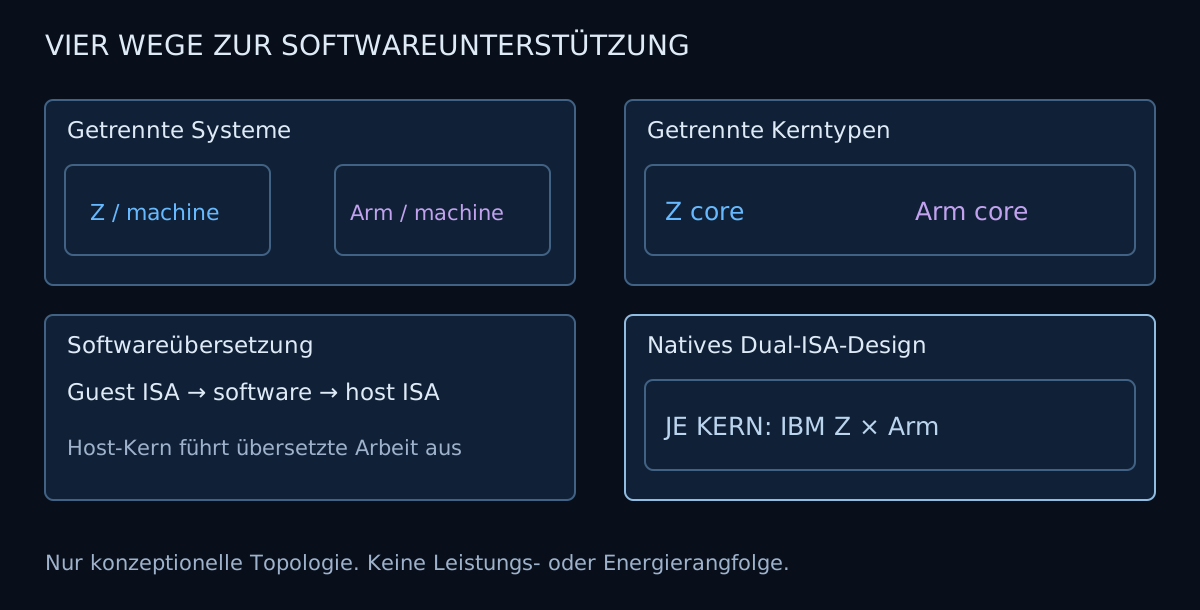
Vier auswählbare Vergleichsbilder zeigen die Alternativen: unterschiedliche Rechner, dedizierte Kerntypen auf einem Chip, eine Emulations- oder Übersetzungsschicht und native Dual-ISA-Fähigkeit pro Kern. Keines erhält eine erfundene Geschwindigkeitswertung. Die Bilder erklären, wo Kompatibilität umgesetzt wird. Sie bilden keine allgemeine Rangliste guter und schlechter Rechnerarchitekturen.
Zwei Programme, Befehl für Befehl nachvollziehbar
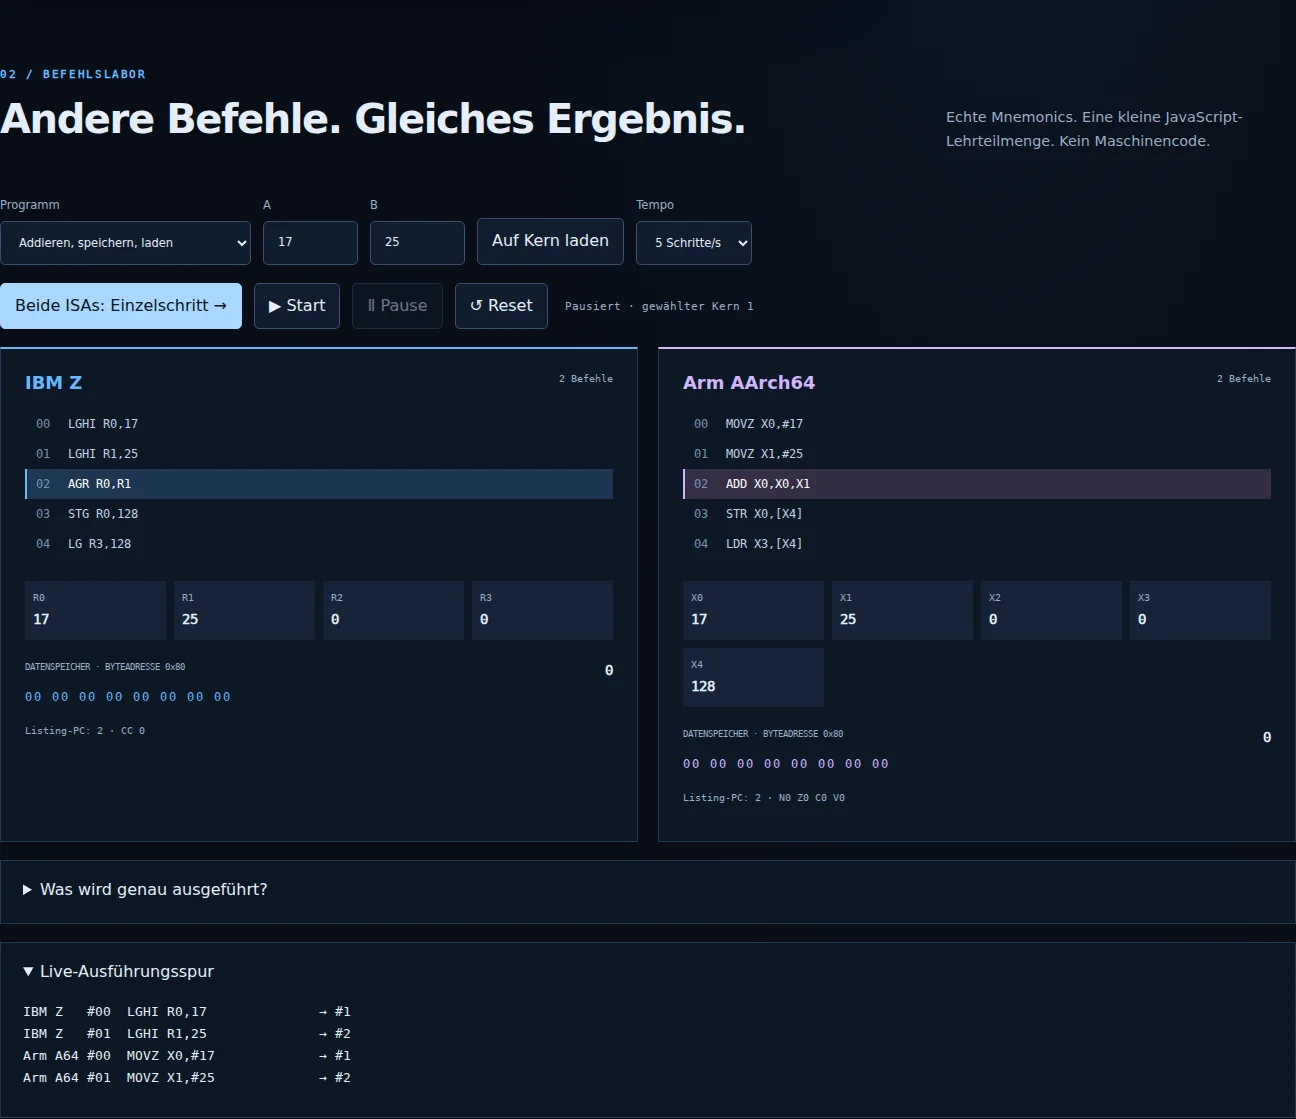
Die erste Übung addiert 17 und 25, speichert das Ergebnis an Byteadresse 128 und liest es in ein anderes Register zurück. Im IBM-Z-Listing lädt LGHI kleine vorzeichenbehaftete Konstanten. AGR addiert Registerwerte, STG speichert einen 64-Bit-Wert und LG liest ihn. Auf der Arm-Seite übernehmen MOVZ, ADD, STR und LDR diese Aufgaben. Es sind dokumentierte Mnemonics; implementiert werden ausschließlich die im Labor verwendeten Operandenformen. [4] [5]
Das gleiche Ergebnis verdeckt interessante Unterschiede. AGR aktualisiert den modellierten IBM-Bedingungscode. Die gezeigte Arm-ADD-Form setzt keine Flags. Der Z-Speicherbefehl verwendet eine absolute Verschiebung ohne Basisregister. Das Arm-Beispiel nutzt dagegen X4 als Adressregister, das die Lehrumgebung vorab auf 128 setzt. Register enthalten Werte, Datenadressen wählen Bytes aus und der Listing-PC wählt den nächsten Quellbefehl.
Am Ende zeigen beide Speicheransichten die Zahl 42. Die sichtbaren Bytefolgen unterscheiden sich trotzdem: Das Z-Modell legt das höchstwertige Byte zuerst ab. Das Arm-Beispiel verwendet Little Endian und legt das niedrigstwertige Byte zuerst ab. Das beschreibt die gewählten Lehrkonfigurationen. Es sagt nichts über eine unveröffentlichte Speicheranordnung zwischen den Softwareumgebungen des zukünftigen Chips aus.
Die zweite Übung vergleicht die Summe mit 42. CGR und BRC treffen die Z-Entscheidung; CMP und B.EQ übernehmen dies auf Arm. Bei Gleichheit überspringt das Programm einen Befehl, der das Ergebnis sonst durch null ersetzen würde. Ändere eine Eingabe, lade das Programm neu und verfolge den anderen Pfad. Dasselbe Problem hat nun zwei nachvollziehbare Implementierungen.
BRC wertet eine Maske gegen den IBM-Bedingungscode aus; Maske 8 wählt Gleichheit. Arm CMP setzt Bedingungsflags, B.EQ prüft anschließend das Zero-Flag. Für die Rechenwerte verwendet die Implementierung JavaScript BigInt. Dadurch lassen sich 64-Bit-Überläufe und Vergleiche ohne Genauigkeitsverlust durch Fließkommazahlen testen. Es werden keine Binärcodierungen und kein Maschinencode-Decoder erfunden.
Der angezeigte PC ist ein bei null beginnender Index im Quelllisting. Ein genommener Sprung ändert diesen Index, nicht eine Byteadresse. Am Listing-Ende stoppt die Lehrumgebung. Sie führt keinen fiktiven HALT-Befehl aus. Diese Beschränkungen machen den kleinen Quellinterpreter nachvollziehbar und zeigen, warum sein Befehlszähler keine Hardware-Zeitmessung ist.
Eine Transaktion spricht mit einem getrennten Arm-Service
Die Unternehmensdemo beginnt mit einem fiktiven Betrag und einem Häkchen für eine regionsübergreifende Anfrage. Eine Z-Anwendung validiert den Auftrag, erstellt eine strukturierte Service-Nachricht, erhält eine Risikobewertung und beendet den Ablauf. Der Arm-Service verwendet eine vollständig sichtbare deterministische Regel: zehn Punkte je vollständigen tausend Demo-Einheiten, zusätzlich fünfundzwanzig Punkte bei gesetztem Häkchen, höchstens einhundert Punkte insgesamt.
Ab fünfzig Punkten lautet die Entscheidung „prüfen“, darunter „freigeben“. Bei 2.400 Einheiten ohne Häkchen entstehen zwanzig Punkte. Mit Häkchen sind es fünfundvierzig. Ein Betrag von 5.000 Einheiten erreicht auch ohne das Zusatzmerkmal die Prüfschwelle. Diese Zahlen gehören zu meiner eigenen Lehrregel. Sie sind weder gemessene Betrugswahrscheinlichkeiten noch Bankrichtlinien oder ein IBM-Modell.
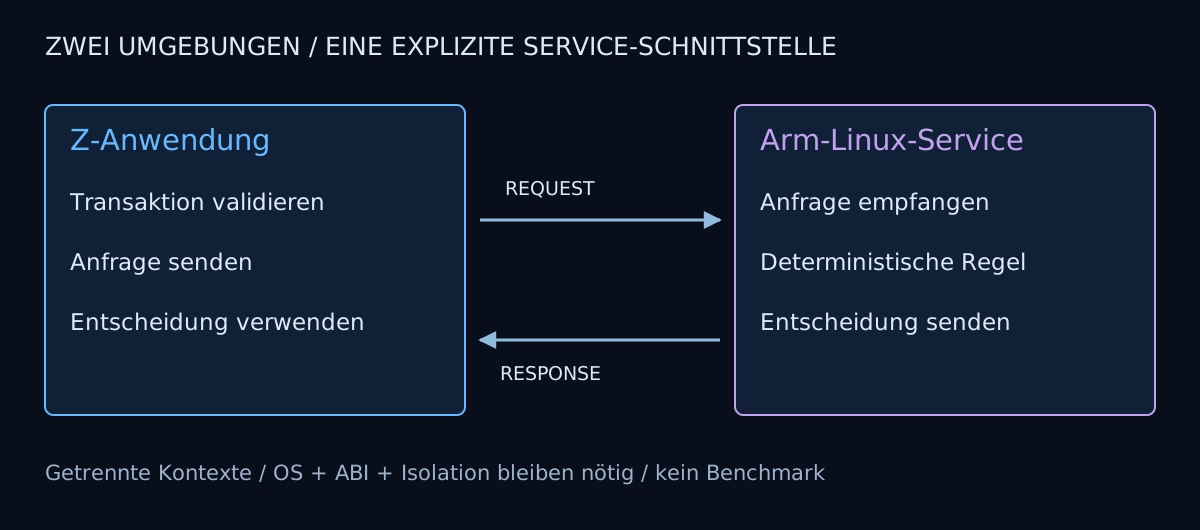
Im Einzelschrittmodus lassen sich die tatsächlichen Anfrage- und Antwortobjekte untersuchen. Die Umschaltung auf getrennte Plattformen verändert die beschriebene Transportgrenze. Sie tauscht nicht heimlich die Risikoregel aus und zeigt keinen erfundenen Latenzvorteil an. Der Unterschied ist die Platzierung: Getrennte Rechner brauchen einen rechnerübergreifenden Pfad, während das integrierte Konzept beide Umgebungen innerhalb einer anderen Systemgrenze anordnet.
Auch auf einer gemeinsamen Plattform braucht eine Schnittstelle Serialisierung, Berechtigungen, Fehlerbehandlung und eine vereinbarte Bedeutung ihrer Datenfelder. Native Befehlsunterstützung beseitigt keine inkompatiblen ABIs. Deshalb zeigt die Demo getrennte Softwareumgebungen mit Nachrichtenverkehr. Sie zeigt keinen einzelnen Prozess, der beliebige Binärdateien beider Architekturen ausführt.
Transaktionsnahe KI: Motivation und technische Grenzen
IBMs Ankündigung umfasst integrierte Inferenzbeschleunigung. Die Motivation liegt nahe: Eine Entscheidung kann während der Prüfung einer Transaktion nützlich sein, statt erst in einem späteren Bericht. IBMs Folgebeitrag ordnet das Design in die Idee ein, moderne Anwendungen näher zu Unternehmensdaten zu bringen. Welchen Nutzen das konkret hat, muss trotzdem für die jeweilige Anwendung bewertet werden. [6]
Allgemein können weniger Bereitstellungsgrenzen beeinflussen, wo Daten serialisiert, übertragen, abgesichert und überwacht werden. Manche Kosten bleiben auch bei räumlicher Nähe bestehen. Ein Service muss die richtigen Merkmale erhalten, ein geeignetes Modell ausführen und ein verwendbares Ergebnis zurückliefern. Der langsamste Bestandteil kann vollständig außerhalb des Prozessors liegen.
Ein Inferenzbeschleuniger ist spezialisierte Hardware. Er ist nicht einfach ein anderer Name für gewöhnliche CPU-Befehle. Auch KI-Anwendungen sind nicht untereinander austauschbar: Modellgröße, Operatoren, Zahlenformate, Softwareunterstützung und Bündelung von Anfragen beeinflussen die Eignung. Aus der Ankündigung folgt weder, dass GPUs überflüssig werden, noch dass jedes vorhandene Modell unverändert läuft.
Unsere deterministische Regel bleibt deshalb sichtbar vom illustrierten KI-Block getrennt. Jeder Score lässt sich mit einfacher Mathematik nachprüfen. So wird die Browserdemo nicht mit einem trainierten Betrugserkennungssystem verwechselt. Trotzdem erklärt sie die Service-Interaktion, die auch eine Anwendung mit echter Inferenz benötigen könnte.
Telum II, Spyre und die Frage nach der Verfügbarkeit
IBM z17 gehört zur bereits bestehenden Generation mit Telum II. Spyre ergänzt in diesem Umfeld die Beschleunigungsmöglichkeiten. IBMs z17-Veröffentlichung behandelt diese Produktgeneration; die Dual-Architektur-Ankündigung vom August 2026 betrifft dagegen zukünftige Plattformen. Das Labor bezeichnet seinen Prozessor deshalb weder als z17 noch als Telum II. [7]
Eine Architekturankündigung, funktionsfähiges Silizium, unterstützte Betriebssysteme und ein allgemein verfügbares kommerzielles System sind verschiedene Meilensteine. Die hier genannten Quellen belegen keinen Verkaufsstart 2027. Ein Datum kann in Diskussionen plausibel erscheinen und als veröffentlichte Tatsachenbehauptung trotzdem unbelegt sein. Bis zu einer maßgeblichen Verfügbarkeitsankündigung bleibt „zukünftiges Design“ die passende Formulierung.
Welche Fragen noch offenbleiben
Die Quellen reichen nicht aus, um den Prozessor nachzubauen. Offen bleiben unter anderem Details zu unterstützten Architekturmerkmalen, Softwarefreigaben, Virtualisierungsschnittstellen, Cache-Organisation, Ressourcenaufteilung und Workload-Isolation. Einzelne Punkte können im weiteren Verlauf genauer dokumentiert werden. Die Ausstellung füllt diese Lücken nicht mit einem erfundenen Halbleiter-Floorplan.
Die Taktfrequenz allein beantwortet keine Frage zur Anwendungsleistung. Arbeit pro Befehl, Abhängigkeiten, Cache-Fehlzugriffe, Speicherverkehr und Betriebssystemverhalten beeinflussen das Ergebnis. Für einen belastbaren Vergleich braucht man reale Workloads, dokumentierte Konfigurationen und reproduzierbare Messungen. Animierte JavaScript-Quellbefehle zu zählen, liefert diese Nachweise nicht.
Genauso wichtig sind praktische Softwarefragen: Welche Distributionen und Bibliotheken werden unterstützt? Wie werden Aktualisierungen ausgeliefert? Wie diagnostiziert man Fehler? Wie werden die Umgebungen gemeinsam verwaltet? Erst die Antworten entscheiden, ob eine neue Architekturfähigkeit zu einer brauchbaren Produktionsplattform wird. Sie verdienen ebenso Aufmerksamkeit wie das ungewöhnliche Kerndesign.
Das Konzept selbst ausprobieren
Beginne mit Kern 01 und der Additionsübung. Führe beide Listings aus, bis sie 42 speichern, und vergleiche anschließend die Bytefolge. Setze zurück, wähle die Sprungübung und ändere einen Operanden. Beobachte, wie der Programmzähler bei Gleichheit den Nullsetzungsbefehl überspringt. Reiche zuletzt eine synthetische Transaktion ein und untersuche jede Service-Nachricht.
Prozessorbild, Lehrinterpreter und Ablaufmodell dienen derselben Frage: Wie hängen Softwareverträge und Hardwarefähigkeiten zusammen? Alle Berechnungen laufen lokal in deinem Browser. Wer genauer nachsehen möchte, findet die Modellgrenzen direkt unter den Bedienelementen und in der Dokumentation. Das Dual-ISA-Prozessorlabor öffnen →
Quellen und technische Referenzen
- IBM: strategische Zusammenarbeit mit Arm, 2. April 2026.
- IBM: zukünftiger Dual-Architektur-Prozessor, 24. August 2026. Primärquelle für Spezifikationen und Zukunftsaussagen.
- Arm: Erweiterung des Enterprise-Ökosystems, 24. August 2026.
- IBM z/Architecture Principles of Operation, SA22-7832-02, Befehlssemantik; ergänzend die IBM-HLASM-Befehlstabelle.
- Arm A-profile A64 Instruction Set Architecture, DDI0602, Ausgabe März 2026, Befehlsformen und Bedingungsflags.
- IBM Think: At Hot Chips, a chip that speaks both mainframe and AI, 28. August 2026.
- IBM-z17-Ankündigung, 8. April 2025, bestehende Generation und Abgrenzung zu Telum II.
Eigene Diagramme und Browseraufnahmen: Dennis Hilk, 16. Oktober 2026. Konzeptionelles Layout, keine IBM-CAD-Darstellung und kein Die-Foto. Unabhängiges Projekt ohne offizielle Unterstützung durch IBM oder Arm. Produkt- und Architekturnamen sind Marken ihrer jeweiligen Inhaber.